SEO log analizi, web sunucusunun ya da CDN’in tuttuğu erişim kayıtlarını inceleyerek arama motoru ve yapay zekâ botlarının sitenizde gerçekte hangi URL’leri, ne sıklıkla ve hangi sonuçla ziyaret ettiğini ortaya çıkarma çalışmasıdır. Crawler araçları sitenin teorik olarak nasıl taranabileceğini, Search Console örneklenmiş bir özetini gösterir. Loglar ise botun kapınızı gerçekte ne zaman ve hangi adres için çaldığının kaydıdır.
Log analizi teknik SEO’nun en az yapılan ama en çok şey söyleyen çalışmalarından biridir. Az yapılmasının nedeni açık: Logları bulmak, temizlemek ve okumak zahmetlidir. Çok şey söylemesinin nedeni de açık: Başka hiçbir veri kaynağı size Googlebot’un davranışını bu kadar doğrudan göstermez.
Bu yazının ilk versiyonunu birkaç yıl önce yazmıştım. O günden bu yana iki şey değişti. Birincisi, loglarda artık yalnız arama motoru botları yok. GPTBot, OAI-SearchBot, ClaudeBot gibi yapay zekâ botları da sitenizi düzenli ziyaret ediyor. İkincisi, Google’ın tarama belgeleri 2025 sonunda yeni bir adrese taşındı ve bot doğrulamasında kullanılan IP listelerinin yeri değişti. Yazıyı bu değişikliklere göre baştan yazdım.
Log Analizi Neyi Gösterir, Neyi Göstermez?
Tarama davranışını anlamak için elinizde üç veri kaynağı var ve her biri farklı bir soruya cevap verir:
| Kaynak | Cevapladığı soru | Sınırı |
|---|---|---|
| Crawler aracı (Screaming Frog vb.) | Site, bağlantılar takip edilerek nasıl taranabilir? | Botun gerçekte ne yaptığını göstermez |
| Search Console Tarama İstatistikleri | Google son dönemde siteyi nasıl taramış? | Özet ve örneklenmiş; URL listesi kapsamlı değil |
| Sunucu / CDN logları | Hangi bot, hangi URL’yi, ne zaman, hangi sonuçla istedi? | Toplaması ve temizlemesi emek ister |
Log analizinin göstermediği şeyleri de baştan söyleyeyim: Loglar bir sayfanın indekslenip indekslenmediğini, hangi sırada çıktığını ya da kaç tıklama aldığını göstermez. Taranmak, indekslenmek demek değildir. Bu yüzden log analizi tek başına değil, crawl ve Search Console verisiyle birleştirildiğinde değer üretir.
Log Analizine Kimin İhtiyacı Var?
Dürüst cevap: Herkesin değil.
Google’ın tarama bütçesi rehberi, tarama bütçesinin esas olarak şu siteler için önemli olduğunu söylüyor: Haftalık değişen bir milyondan fazla benzersiz sayfası olan siteler, günlük değişen on binden fazla sayfası olan siteler ve Search Console’da çok sayıda URL’si "Bulundu - şu anda dizine eklenmemiş" durumunda olan siteler. Tarama İstatistikleri raporunun yardım sayfası da yaklaşık bin sayfanın altındaki sitelerin bu ayrıntıya genellikle ihtiyaç duymadığını belirtiyor.
Yani 40 sayfalık bir kurumsal sitede log analizi genellikle önceliğiniz değildir. Search Console’daki Tarama İstatistikleri raporu çoğu soruyu cevaplar.
Ama log analizinin değeri yalnız tarama bütçesiyle sınırlı değil. Şu durumlarda site büyüklüğünden bağımsız olarak işe yarar:
- Büyük e-ticaret siteleri: Filtre, sıralama ve parametre kombinasyonları binlerce gereksiz URL üretebilir.
- Migrasyonlar: Taşımadan sonra Googlebot eski URL’leri hâlâ istiyor mu, istediklerinde doğru yönlendirmeyi mi alıyor?
- İndeksleme sorunları: Önemli sayfalar neden geç ya da hiç taranmıyor?
- Sunucu sorunları: 5xx hataları hangi saatlerde, hangi bölümlerde yoğunlaşıyor?
- Yapay zekâ görünürlüğü: Hangi AI botları sitenize geliyor, hangi sayfaları okuyor, robots.txt kararlarınız gerçekten uygulanıyor mu?
Bir Log Satırının Anatomisi
Çoğu web sunucusu (Apache, Nginx) erişim kayıtlarını "combined log format" denen bir yapıda tutar. Her istek tek bir satırdır:
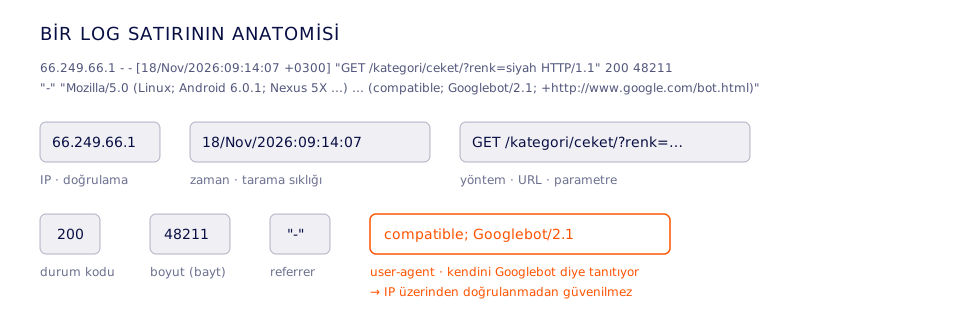
Bu satırdan SEO açısından okunan bilgiler şunlar:
- IP adresi: İsteğin gerçekten iddia ettiği bottan gelip gelmediğini doğrulamak için kullanılır.
- Zaman damgası: Tarama sıklığını, yeni sayfaların ne kadar sürede keşfedildiğini ve sorunların zamanlamasını gösterir.
- İstek satırı: Hangi URL’nin, hangi parametrelerle istendiğini gösterir.
- Durum kodu: Botun aldığı cevap: 200, 301, 404, 500…
- Boyut: Yanıtın büyüklüğü. Anormal küçük yanıtlar boş ya da hatalı sayfalara işaret edebilir.
- User-agent: İsteği yapanın kendini nasıl tanıttığı. Bu alan kolayca taklit edilebilir. Doğrulanmadan güvenilmemesi gereken alan budur.
Örnekteki user-agent Googlebot Smartphone’a aittir. Google’ın belgesine göre Google sitelerin çoğunu mobil sürümleri üzerinden indekslediği için tarama isteklerinin büyük çoğunluğu mobil tarayıcıdan gelir.
Log Analizi Adım Adım
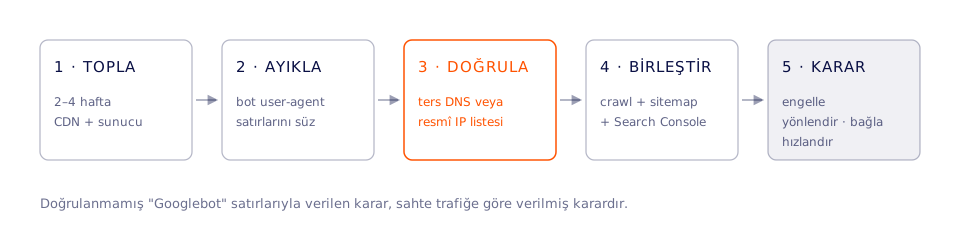
Adım 1: Logları Toplamak
İlk iş, logların nerede durduğunu bulmaktır. Bu, altyapınıza göre değişir:
- Kendi sunucunuz veya VPS: Apache’de genellikle
access.log, Nginx’teaccess.logdosyaları. Çoğu sistem bunları günlük olarak arşivler. - Paylaşımlı hosting: Hosting panellerinde genellikle "Raw Access Logs" ya da benzeri bir bölüm bulunur. Bazı firmalar logları kısa süre tutar. Bu yüzden önce saklama süresini öğrenin.
- CDN arkasındaki siteler: Burada önemli bir tuzak var. CDN önbellekten cevap verdiğinde istek kaynak sunucuya hiç ulaşmaz. Yani yalnız kaynak sunucunun loglarına bakarsanız, botların isteklerinin bir kısmını hiç görmezsiniz. CDN’in kendi istek kayıtlarına erişmeniz gerekir. Hangi log setine erişebildiğiniz, CDN’e ve kullandığınız plana bağlıdır.
- Barındırılan platformlar: Shopify gibi platformlar ham sunucu loglarını mağaza sahibine vermez. Bu durumda ana kaynağınız Search Console’un Tarama İstatistikleri raporudur.
Ne kadar süre? Tek günlük log yanıltıcıdır. Tarama haftanın günlerine, sitedeki güncellemelere ve sunucu durumuna göre dalgalanır. Anlamlı bir tablo için en az iki, tercihen dört haftalık veri toplayın. Bir migrasyonu izliyorsanız taşımadan önceki ve sonraki dönemi ayrı ayrı alın.
KVKK notu: Log dosyalarında gerçek kullanıcıların IP adresleri ve ziyaret ettikleri sayfalar bulunur. IP adresleri, bir kişiyle ilişkilendirilebildiği durumlarda kişisel veri sayılabilir. Logları bir ajansla ya da harici bir araçla paylaşmadan önce yalnız analiz için gereken bot satırlarını ayıklamak, hem veri hacmini küçültür hem de gereksiz kişisel veri aktarımını önler.
Adım 2: Bot Satırlarını Ayıklamak
İkinci adım, milyonlarca satır arasından bot isteklerini ayırmaktır. İlk elemede user-agent alanı kullanılır. SEO açısından en sık incelenen botlar şunlar:
| Bot | Sahibi | Amacı |
|---|---|---|
| Googlebot (Smartphone / Desktop) | Google Arama için tarama | |
| Googlebot-Image, Googlebot-Video | Görsel ve video arama | |
| AdsBot-Google | Google Ads açılış sayfası kalitesi | |
| Bingbot | Microsoft | Bing ve Bing’e dayanan hizmetler |
| OAI-SearchBot | OpenAI | ChatGPT arama özelliklerinde siteleri göstermek |
| GPTBot | OpenAI | Model eğitimi için içerik toplama |
| ChatGPT-User | OpenAI | Bir kullanıcının ChatGPT’de istediği anlık sayfa ziyareti |
| Claude-SearchBot | Anthropic | Claude’un arama sonuçlarının kalitesi |
| ClaudeBot | Anthropic | Model eğitimi için içerik toplama |
| Claude-User | Anthropic | Bir kullanıcının Claude’da istediği anlık sayfa ziyareti |
Bu tablodaki ayrım önemli: Eğitim botu, arama botu ve kullanıcı adına gelen ziyaret aynı şey değildir. OpenAI ve Anthropic bu botları ayrı ayrı tanımlıyor ve her biri için robots.txt üzerinden ayrı karar vermenize izin veriyor. Örneğin eğitim botunu engelleyip arama botuna izin verebilirsiniz. OpenAI’ın belgesi, kullanıcı tarafından başlatılan ChatGPT-User ziyaretlerinde robots.txt kurallarının uygulanmayabileceğini de açıkça belirtiyor.
Google tarafında bir not: Google-Extended, Google’ın yapay zekâ modellerinin eğitimi için kullanılan bir robots.txt belirtecidir. Ayrı bir bot olarak gelmez. Bu yüzden loglarda "Google-Extended" diye bir user-agent görmezsiniz.
Yapay zekâ botlarının sitenizi nasıl okuduğu, bu sistemlerde görünürlüğün de bir ön koşulu. Bu konuyu Search Everywhere Optimization yazısında ve İnovatif360’ın ChatGPT markanızı neden önermiyor yazısında ayrıca ele aldık.
Adım 3: Botları Doğrulamak
Log analizinin en sık atlanan adımı budur. Atlandığında da bütün analiz yanlış zemine oturur.
User-agent alanına herkes "Googlebot" yazabilir. Kazıyıcılar, rakip analiz araçları ve kötü niyetli botlar engellenmemek için sık sık kendilerini Googlebot gibi tanıtır. Doğrulamadan yapılan analizde "Googlebot parametreli sayfalara çok vakit harcıyor" sonucuna varırsınız, oysa o istekleri yapan Googlebot değildir.
Google’ın doğrulama belgesine göre iki yöntem var:
1. Ters DNS ve ileri DNS kontrolü:
host 66.249.66.1
# → crawl-66-249-66-1.googlebot.com
host crawl-66-249-66-1.googlebot.com
# → 66.249.66.1  (ilk IP ile aynı olmalı)
Dönen alan adı googlebot.com, google.com veya googleusercontent.com ile bitmeli ve ileri sorgu aynı IP’ye dönmelidir.
2. Yayımlanan IP aralıklarıyla eşleştirme: Büyük log dosyalarında tek tek DNS sorgusu yapmak pratik değildir. Google, bot kategorilerine göre IP aralıklarını JSON dosyaları olarak yayımlar. Googlebot gibi genel tarayıcılar için dosya common-crawlers.json’dır. Bu dosyalar 2026’da developers.google.com/static/crawling/ipranges/ altına taşındı. Eski adresi kullanan script’leriniz varsa güncelleyin.
OpenAI kendi botları için openai.com/gptbot.json, openai.com/searchbot.json ve openai.com/chatgpt-user.json dosyalarını yayımlıyor. Anthropic de botlarının IP listesini claude.com/crawling/bots.json adresinde paylaşıyor.
Doğrulamadan geçemeyen istekleri ayrı bir grupta tutun. Bu grubun büyüklüğü de başlı başına bir bulgudur: Sitenizi kendini Googlebot diye tanıtan ama Googlebot olmayan ne kadar trafik yokluyor?
Adım 4: Doğru Soruları Sormak
Temizlenmiş ve doğrulanmış bot verisiyle şu sorular sorulur. Benim log analizinde ilk baktığım yerler de bunlar:
1. Durum kodu dağılımı: Googlebot’un isteklerinin yüzde kaçı 200, yüzde kaçı 3xx, 4xx ve 5xx alıyor? Yönlendirme ve hata oranının yüksek olması, tarama zamanının boşa gittiği anlamına gelir.
2. Dizin bazında tarama payı: Tarama isteklerinin bölümlere göre dağılımı, o bölümlerin işletme için önemiyle örtüşüyor mu? Örneğin taramanın büyük kısmı blog etiket sayfalarına ya da arşivlere gidiyor, gelir getiren kategori sayfalarına az gidiyorsa öncelikler ters çalışıyor demektir.
3. Parametreli URL payı: Taranan URL’lerin ne kadarı ? içeriyor? Filtre, sıralama, oturum ve takip parametreleri, e-ticaret sitelerinde tarama bütçesinin en bilinen kaçağıdır.
4. Taranmayan önemli sayfalar: Sitemap’te olan ama inceleme döneminde Googlebot’un hiç istemediği URL’ler hangileri? Bu sayfalar genellikle zayıf iç bağlantı alıyor ya da sitenin derinlerinde kalıyor.
5. Yetim ve eski URL’ler: Botun istediği ama sitenizin hiçbir yerinden bağlantı almayan URL’ler hangileri? Eski kampanya sayfaları, silinmiş ürünler, eski site yapısından kalan adresler burada çıkar.
6. Yönlendirme zincirleri ve 404’ler: Googlebot hangi eski URL’ler için yönlendirme alıyor? Bu yönlendirmeler tek adımda doğru sayfaya mı gidiyor, yoksa zincir mi oluşturuyor?
7. Sunucu hataları ve yanıt süresi: 5xx hataları belirli saatlerde mi yoğunlaşıyor? Google, sunucu hataları ve aşırı yük sinyalleri (HTTP 429) arttığında tarama kapasitesini düşürür.
8. Yeni içeriğin keşif süresi: Yayımlanan bir sayfa ilk kez ne zaman taranıyor? Bu süre, sitenin keşif altyapısının (iç bağlantılar, sitemap, lastmod) ne kadar sağlıklı olduğunu gösterir.
9. AI botlarının ilgi alanı: Yapay zekâ botları hangi sayfaları okuyor? Robots.txt’te engellediğiniz botlar gerçekten gelmeyi bıraktı mı?
Adım 5: Logu Diğer Verilerle Birleştirmek
Log verisi tek başına "ne oldu"yu söyler. "Neden" ve "ne yapmalı" sorusunun cevabı, logu diğer verilerle yan yana koyduğunuzda çıkar:
| Durum | Log | Crawl | Sitemap | Yorum |
|---|---|---|---|---|
| Sağlıklı | Taranıyor | Bağlantı alıyor | Var | Beklenen durum |
| Keşif sorunu | Taranmıyor | Bağlantı alıyor | Var | Derinlik, iç bağlantı veya kalite sinyali zayıf |
| Yetim sayfa | Taranıyor | Bağlantı almıyor | Yok | Eski veya unutulmuş URL; yönlendirme ya da kaldırma kararı gerekir |
| İsraf | Yoğun taranıyor | Bağlantı alıyor | Yok | Parametre veya ince sayfa; tarama erişimi yönetilmeli |
Bu tabloya Search Console’dan gösterim ve tıklama verisini de eklediğinizde, hangi sorunun gerçekten trafik kaybettirdiğini görürsünüz. Böylece önceliklendirme tahmine değil veriye dayanır.
Adım 6: Bulguyu Karara Çevirmek
Log analizinin değeri, ürettiği kararlar kadardır. Tipik bulgular ve karşılık gelen kararlar:
- Önemsiz URL’ler yoğun taranıyor: Google, tarama bütçesi için önemsiz URL’leri robots.txt ile engellemeyi öneriyor ve bu amaçla noindex kullanılmamasını özellikle belirtiyor. Noindex’li bir sayfanın da taranması gerekir. Kalıcı olarak kaldırılan sayfalar için 404 veya 410 döndürülmeli.
- Önemli sayfalar taranmıyor: İç bağlantı yapısı güçlendirilmeli, sayfalar sitemap’te güncel
lastmodile yer almalı. - Yönlendirme zincirleri: Her eski URL tek adımda nihai hedefe gitmeli.
- 5xx ve yavaş yanıt: Sunucu kapasitesi ve önbellek altyapısı ele alınmalı. Google, sunucunun zorlandığını gördüğünde taramayı kendiliğinden azaltır.
- Sahte bot trafiği: Doğrulamadan geçmeyen yoğun trafik, güvenlik ve sunucu yükü açısından ayrıca değerlendirilmeli.
- AI botları: Hangi botlara izin verileceği bir iş kararıdır. Arama botlarını engellemek, o sistemlerin sonuçlarında görünürlüğü azaltabilir. Eğitim botları için karar markanın içerik politikasına bağlıdır.
Araçlar
Log analizinin bir aracı yok, ihtiyaca göre seçilen bir araç seti var:
Screaming Frog Log File Analyser: SEO’cuların en yaygın kullandığı masaüstü araç. Apache ve W3C (IIS) formatlarındaki logları otomatik tanır, botları doğrulama özelliği vardır ve log verisini crawl verisiyle birleştirebilir. Ücretsiz sürümü tek projede 1.000 log satırıyla sınırlıdır. Gerçek bir analiz için lisans gerekir. User-agent alanı içermeyen Common Log Format’ı desteklemez.
Komut satırı: Küçük ve orta ölçekli loglarda ilk keşif için grep ve awk yeterlidir. Combined log formatında 7. alan URL’yi, 9. alan durum kodunu verir:
# Googlebot isteklerinin durum kodu dağılımı
grep "Googlebot" access.log | awk '{print $9}' | sort | uniq -c | sort -rn

# Googlebot'un en çok istediği 50 URL
grep "Googlebot" access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -50

# Parametreli URL'lere giden Googlebot isteği sayısı
grep "Googlebot" access.log | awk '{print $7}' | grep -c "?"
Bu komutlar user-agent’a göre filtreler, yani doğrulama yapmaz. İlk fikir edinmek için kullanın, karar vermeden önce doğrulanmış veriyle tekrarlayın.
BigQuery, Python ve Looker Studio: Günde milyonlarca satır üreten sitelerde loglar bir veri ambarına aktarılır, sorgular SQL ile yazılır ve sonuçlar düzenli bir panoya bağlanır. Büyük e-ticaret sitelerinde log analizi bir defalık bir denetim değil, sürekli izlenen bir veri hattı olmalıdır.
Search Console Tarama İstatistikleri: Ham loga erişemediğiniz her durumda başvuracağınız kaynak. Yanıt türüne, dosya türüne, tarama amacına (keşif / yenileme) ve Googlebot türüne göre kırılım verir. Son 90 güne ait sunucu durumunu da gösterir. Raporun sınırlarını bilmek gerekir: Yalnız alan adı veya kök seviyedeki mülklerde kullanılabilir, örnek URL listesi kapsamlı değildir ve sayımlar sunucu loglarından biraz farklı olabilir.
Migrasyon Sonrası Log Kontrolü
Log analizinin en somut fayda sağladığı anlardan biri site taşımalarıdır. Taşımadan sonraki haftalarda Googlebot eski URL’leri istemeye devam eder. Loglar size şunu gösterir: Bu isteklerin her biri doğru yeni sayfaya tek adımda mı gidiyor, yoksa 404 ya da ilgisiz bir sayfaya mı düşüyor?
Taşıma sonrası kontrol listesi:
- 01Eski URL listesini çıkarın
- 02Taşıma sonrası loglarda bu URL’lere gelen bot isteklerini süzün
- 03Her birinin aldığı durum kodunu ve hedefini kontrol edin
- 04404 alan ama trafik ya da bağlantı geçmişi olan URL’ler için doğru hedefe 301 kurun
- 05Zincirleri tek adıma indirin
- 06Birkaç hafta boyunca eski URL isteklerinin azalmasını izleyin
Ham loga erişim olmadığında aynı mantık başka veriyle kurulabilir. Kendi sitemizin yakın zamandaki migrasyon onarımında eski URL envanterini Search Console’un sayfa verisinden ve eski sitenin arşiv kayıtlarından çıkardık. Her eski adresin bugün canlıda ne döndürdüğünü tek tek kontrol ettik. Log, bu süreçte en kesin kaynaktır ama tek kaynak değildir.
Sık Yapılan Hatalar
- User-agent’a güvenmek. Doğrulanmamış veriyle verilen karar, sahte trafiğe göre verilmiş karardır.
- Çok kısa dönem analiz etmek. Bir günlük log, tarama davranışının dalgalı doğasını göstermez.
- CDN arkasında yalnız kaynak sunucu loguna bakmak. Önbellekten dönen istekler bu loglarda yoktur.
- Tarama sayısını başarı ölçütü yapmak. Daha fazla tarama tek başına iyi bir şey değildir. Önemli olan doğru sayfaların, doğru sıklıkla taranmasıdır.
- Tarama bütçesi için noindex kullanmak. Google bunu özellikle önermiyor. Taranmasını istemediğiniz URL’ler için robots.txt kullanılmalı.
- CSS ve JavaScript dosyalarını robots.txt ile engellemek. Google sayfayı işlerken bu dosyalara ihtiyaç duyar. Engellendiklerinde sayfanın doğru anlaşılması zorlaşabilir.
- Bulguyu karara çevirmemek. Güzel grafiklerle biten ama hiçbir yönlendirme, engelleme ya da iç bağlantı değişikliği üretmeyen log analizi, sadece bir rapordur.
Sonuç
Log analizi, teknik SEO’da tahmini veriyle değiştirmenin en doğrudan yoludur. Her site için gerekli değildir. Küçük sitelerde Search Console’un Tarama İstatistikleri raporu çoğu soruyu cevaplar. Ama büyük e-ticaret sitelerinde, migrasyonlarda ve açıklanamayan indeksleme sorunlarında başka hiçbir kaynağın veremediği kesinliği verir.
Doğru sıra şudur: Yeterli süreli logu toplayın, bot satırlarını ayıklayın, mutlaka doğrulayın, crawl ve Search Console verisiyle birleştirin ve her bulguyu somut bir karara bağlayın.
Log analizi, teknik SEO çalışmasının bir parçasıdır ve en iyi sonucu on-page ve performans (Core Web Vitals) çalışmasıyla birlikte verir. Sitenizin arama ve yapay zekâ sistemlerindeki görünürlüğünü birlikte ele almak isterseniz AI Search Visibility ve Organic Authority Strategy yaklaşımlarımıza göz atabilirsiniz. Search Console’da dizine eklenmeyen sayfalarla uğraşıyorsanız İnovatif360’ın bu konudaki rehberi iyi bir sonraki adım olur.
Sıkça Sorulan Sorular
SEO log analizi nedir?
SEO log analizi, sunucu veya CDN erişim kayıtlarını inceleyerek arama motoru ve yapay zekâ botlarının sitede gerçekte hangi URL’leri, ne sıklıkla ve hangi sonuçla ziyaret ettiğini ortaya çıkarma çalışmasıdır.
Log analizi her site için gerekli midir?
Hayır. Google, tarama bütçesinin esas olarak çok büyük veya çok sık değişen siteler için önemli olduğunu belirtir. Küçük sitelerde Search Console’un Tarama İstatistikleri raporu genellikle yeterlidir. Ancak migrasyonlar ve açıklanamayan indeksleme sorunlarında log analizi her ölçekte işe yarar.
Gerçek Googlebot nasıl doğrulanır?
İsteğin IP adresi için ters DNS sorgusu yapılır. Dönen alan adı googlebot.com, google.com veya googleusercontent.com ile bitmeli ve bu alan adının ileri DNS sorgusu aynı IP’ye dönmelidir. Büyük log dosyalarında Google’ın yayımladığı IP aralığı dosyalarıyla eşleştirme yapılabilir.
Search Console Tarama İstatistikleri raporu log analizinin yerini tutar mı?
Kısmen. Rapor taramanın genel tablosunu, yanıt türlerini, dosya türlerini ve sunucu durumunu gösterir. Ancak özet niteliğindedir, URL örnekleri kapsamlı değildir ve diğer botları göstermez. Ham loga erişim yoksa en iyi alternatiftir.
Loglarda hangi yapay zekâ botları görünür?
En yaygınları OpenAI’ın GPTBot, OAI-SearchBot ve ChatGPT-User botları ile Anthropic’in ClaudeBot, Claude-SearchBot ve Claude-User botlarıdır. Bu botların bir kısmı model eğitimi, bir kısmı arama, bir kısmı da kullanıcı adına anlık sayfa ziyareti için gelir. Google-Extended ise ayrı bir bot değil, robots.txt belirtecidir. Bu yüzden loglarda görünmez.
Tarama bütçesini artırmak için noindex kullanılabilir mi?
Hayır. Google tarama bütçesi için noindex kullanılmamasını önerir, çünkü noindex’in görülebilmesi için sayfanın yine de taranması gerekir. Taranmasını istemediğiniz önemsiz URL’ler için robots.txt, kalıcı olarak kaldırılan sayfalar için 404 veya 410 kullanılmalıdır.
Shopify’da log analizi yapılabilir mi?
Shopify ham sunucu loglarını mağaza sahiplerine sunmaz. Bu nedenle Shopify mağazalarında Search Console’un Tarama İstatistikleri raporu ve URL Denetleme aracı ana kaynaklardır.
Kaynaklar
- Google Crawling — Büyük siteler için tarama bütçesi yönetimi.
- Google Crawling — Google tarayıcılarından gelen istekleri doğrulama.
- Google Crawling — Google tarayıcıları ve getiricilerine genel bakış.
- Google Search Central — Googlebot.
- Google Search Console Yardım — Tarama İstatistikleri raporu.
- Google Search Central Blog — Google tarayıcılarının IP aralığı dosyalarının yeni adresi.
- OpenAI — OpenAI tarayıcılarına genel bakış.
- Anthropic — Anthropic’in botları ve tarayıcıları.
- Screaming Frog — Log File Analyser SSS.